guest@mda ~ $ cat blog/monitoreo-y-seguridad-en-aws.es.md
Alertar por síntomas: diseño de monitoreo y seguridad en AWS
Diseño de referencia con herramientas habituales; se omiten detalles internos de cualquier empleador.
La mayoría de los sistemas de monitoreo fallan por exceso: sobran datos y alertas que nadie lee. La tesis de esta nota es que conviene alertar solo por síntomas que percibe el usuario y mandar todo lo demás a un tablero, para un equipo chico que opera en AWS.
Las señales que miraría primero
Las señales clásicas de operación son latencia, tráfico, errores y saturación. Agregaría seguridad como una quinta, tratada aparte porque tiene otro ritmo y otros destinatarios.
La latencia es cuánto tarda el servicio en responder, y el tráfico, cuánta demanda recibe. Los errores miden qué proporción de pedidos falla. La saturación indica qué tan cerca está un recurso de agotarse, como las conexiones a la base o el disco. Con esas cuatro se puede responder si el servicio funciona sin conocer el detalle de cada componente.
Métricas, logs y hallazgos de seguridad por separado
Prometheus recolecta las métricas, Mimir las almacena a largo plazo y Loki guarda los logs, con Grafana consultando todo desde un solo lugar. Prometheus y Loki comparten el modelo de etiquetas, lo que facilita pasar de un gráfico a los logs de ese mismo momento.
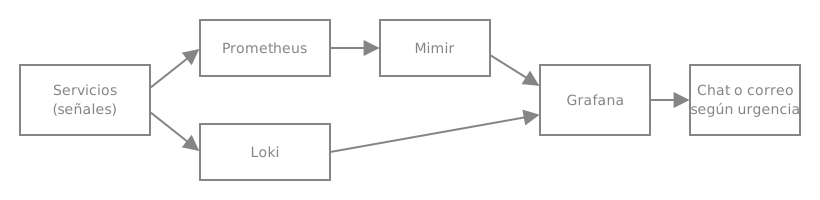 Diseño de referencia: de la señal a la alerta.
Los hallazgos de seguridad quedan fuera de este circuito. Son eventos discretos con severidad y dueño, no series de tiempo, y conviene que vivan donde se pueda seguir el estado de cada uno.
Alertar por síntomas
Una alerta debería corresponder a algo que el usuario ya nota o está por notar: falla el health check externo, la tasa de errores sube de forma sostenida o un recurso se acerca a su límite. Un ejemplo ilustrativo de regla en Prometheus, con umbral y ventana que habría que calibrar con datos reales:
# Ilustrativo: los valores son de ejemplo
- alert: AltaTasaDeErrores
  expr: |
    sum(rate(http_requests_total{status=~"5.."}[5m]))
      / sum(rate(http_requests_total[5m])) > 0.05
  for: 10m
  labels:
    severity: page
Un paso más maduro es alertar por SLO con burn rate: en lugar de un umbral fijo, se mide qué tan rápido se consume el presupuesto de errores y se avisa cuando el ritmo, en una ventana corta y en una larga, amenaza con agotarlo.
No alertaría por la CPU en sí misma, porque fluctúa todo el tiempo y casi nunca significa algo. La saturación, en cambio, sí es una señal: conviene avisar solo cuando un recurso se acerca a su límite de verdad, como un disco al 90% o un pool de conexiones casi agotado. Cada alerta que no lleva a una acción enseña al equipo a ignorarlas, y esa costumbre alcanza también a las que importan.
Los canales dependen de la urgencia. Los errores sostenidos son un incidente y deberían ir por un canal rápido, como mensajería o un sistema de guardia. El correo queda para lo no urgente: avisos de anticipación, resúmenes y todo lo que puede esperar a la mañana.
Security Hub agrega y no está en el camino del tráfico
Security Hub no ve el tráfico. Agrega hallazgos de otros servicios, y esa diferencia importa al dibujar el diseño.
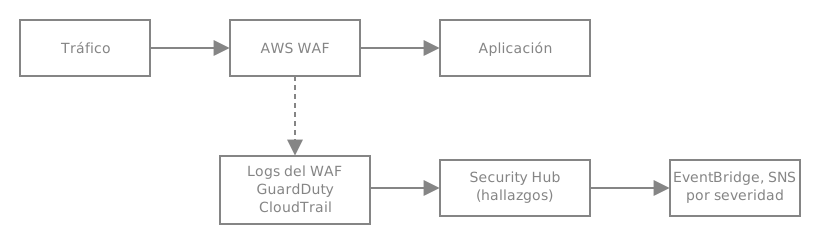 El tráfico va por un camino y los hallazgos por otro.
Con Organizations, lo razonable es juntar los hallazgos de todas las cuentas en una cuenta de seguridad. Como diseño de referencia, los hallazgos llegan a Amazon EventBridge, una regla filtra por severidad alta o crítica y publica en un tema de SNS, que reparte la notificación al responsable del recurso afectado y no a una lista general. El resto queda en la consola con una revisión periódica agendada.
El WAF como fuente de señal
Un WAF no es solo un bloqueador. Los logs de qué reglas se activan, desde dónde y con qué frecuencia muestran qué se intenta contra la aplicación. Un salto inusual en una regla es una señal útil aunque todo ese tráfico haya sido bloqueado.
Las reglas nuevas conviene ponerlas primero en modo conteo, revisar qué dispararían y recién después pasarlas a bloqueo. Una regla estricta que corta tráfico legítimo suele descubrirse cuando alguien se queja, un mal momento para enterarse.
Qué dejaría fuera al principio
Las métricas por usuario o por pedido y cualquier cosa con etiquetas de alta cardinalidad: es lo más caro de almacenar y consultar, y rara vez se necesita el primer día. Tampoco armaría un tablero por componente ni alertas sobre métricas que nadie sabe interpretar. Si no se puede decir qué hacer al recibir la alerta, no es una alerta.
Riesgos y límites
El esquema tiene costuras. La fatiga de alertas reaparece aunque se empiece bien, porque las reglas se acumulan; hace falta una revisión periódica para borrar las que nunca llevaron a una acción. Una cadena de notificación sin respaldo puede fallar en silencio, así que conviene probarla de punta a punta. Un fallo que no deja huella en un health check ni en los logs no lo ve nada de esto. El costo de las etiquetas puede dispararse si no se controla la cardinalidad desde el principio. Y los hallazgos de Security Hub pueden ser muchos y de urgencias muy distintas: clasificarlos es lo que más se descuida.
Por dónde empezar con poco
Un health check externo y una alerta de tasa de errores. Prometheus y Grafana con un par de tableros de las cuatro señales. GuardDuty y CloudTrail activados, Security Hub agregando y una notificación para severidad alta. El WAF en modo conteo con sus logs a la vista.
Al mes habría que revisar qué alertas se dispararon y cuáles sirvieron, y ajustar desde ahí. Corregir un diseño chico con datos cuesta menos que defender uno grande sin ellos.