guest@mda ~ $ cat blog/idp-plataforma-interna.es.md
Una plataforma interna vale si lo seguro es lo más fácil de hacer
Una plataforma interna se justifica por las decisiones que le ahorra a quien solo quiere entregar una funcionalidad, más que por la infraestructura que esconde. Si el camino seguro no es también el más corto, la gente toma el otro, y con razón.
Es un diseño de referencia, y se omiten detalles internos de cualquier empleador.
El problema y para quién es
El problema es la carga cognitiva ajena al producto: cómo se pide un acceso, dónde vive un secreto, qué permisos necesita un servicio, cómo se configura un pipeline. Cada pregunta tiene una respuesta correcta, y que cada dev la reconstruya por su cuenta es un desperdicio.
El usuario es el dev que hoy copia el servicio de al lado porque es lo más rápido. Hace lo razonable con lo que tiene delante. La plataforma tiene que ser mejor que copiar.
Por dónde empezaría
Por lo mínimo útil: una tarea que hoy cada persona hace distinto y que duele, probablemente crear un servicio nuevo o cargar un secreto. La convertiría en un comando o una pantalla de un portal, con una guía corta al lado.
Los controles de seguridad tienen que vivir en el pipeline desde el primer día. Agregarlos después es más difícil de justificar, porque ya hay servicios que asumen que no existen.
Un ejemplo ilustrativo, con nombres genéricos que no corresponden a ninguna herramienta real:
plataforma servicio crear --nombre facturas
plataforma secreto cargar --servicio facturas --entorno test
Cada comando encapsula una decisión que antes se tomaba a mano: el dev no elige cómo se guarda un secreto, elige cuál.
El camino pavimentado y las salidas de emergencia
Una plantilla (lo que suele llamarse golden path) crea un servicio ya conectado a lo que importa: secretos gestionados, pipeline con OIDC en vez de credenciales de larga duración, escaneo de vulnerabilidades y documentación registrada en un lugar central. Si crear un servicio bien hecho cuesta poco, copiar uno viejo pierde atractivo.
Conviene un camino pavimentado y no uno obligatorio. Salirse no está prohibido, pero afuera no hay asfalto.
La salida de emergencia se diseña desde el principio. Si la plataforma es la única forma de hacer algo, el día que no cubre un caso el dev queda trabado y sin el conocimiento para resolverlo. La salida tiene que estar documentada, tener responsable y dejar registro, para que cada excepción muestre qué le falta a la plataforma.
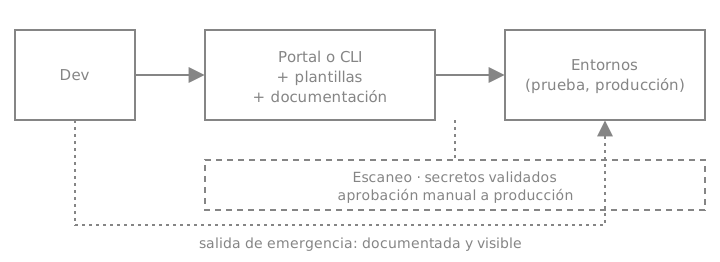 Diseño de referencia, genérico: los controles están en el camino y no al final.
Un ejemplo concreto del pipeline
Esto es ilustrativo, no un pipeline real. Un fragmento de GitHub Actions que autentica contra AWS con OIDC (sin claves guardadas) y escanea la imagen con Trivy antes de publicarla:
name: build
on:
  push:
    branches: [main]

permissions:
  id-token: write   # necesario para pedir el token OIDC
  contents: read

jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - uses: aws-actions/configure-aws-credentials@v4
        with:
          role-to-assume: arn:aws:iam::111122223333:role/ci-facturas
          aws-region: us-east-1

      - name: Build
        run: docker build -t facturas:${{ github.sha }} .

      - name: Escaneo de vulnerabilidades
        uses: aquasecurity/trivy-action@0.28.0
        with:
          image-ref: facturas:${{ github.sha }}
          severity: CRITICAL,HIGH
          exit-code: "1"        # corta el pipeline si hay hallazgos
          ignore-unfixed: true

      - name: Publicar
        run: |
          aws ecr get-login-password | docker login --username AWS --password-stdin 111122223333.dkr.ecr.us-east-1.amazonaws.com
          docker tag facturas:${{ github.sha }} 111122223333.dkr.ecr.us-east-1.amazonaws.com/facturas:${{ github.sha }}
          docker push 111122223333.dkr.ecr.us-east-1.amazonaws.com/facturas:${{ github.sha }}
El rol ci-facturas confía solo en ese repositorio y esa rama, y tiene permiso únicamente sobre su propio repositorio de imágenes. Si el escaneo falla, no se publica nada. La plantilla entrega esto ya armado, así que el dev no escribe ni una línea.
Como diseño de referencia, en el cluster aplicaría la misma idea: un rol de servicio por pod, con los permisos mínimos que ese servicio necesita.
Los controles viven en el flujo
Un chequeo que hay que pedir se saltea; uno que corre solo, no. En el flujo normal van el escaneo de vulnerabilidades, la validación de secretos antes del despliegue y la aprobación manual para producción. Para el acceso, SSO con MFA. Para los entornos de prueba, datos con la información personal anonimizada.
La aprobación manual a producción la dejaría a propósito. Una segunda persona que ve el cambio antes de que salga justifica la espera, y no la reemplazaría por automatización completa.
Build vs buy
No hay una respuesta única. El criterio que usaría:
| Opción | Cuándo conviene | Costo a tener en cuenta |
|---|---|---|
| Portal tipo Backstage | Muchos equipos y servicios, y hace falta un catálogo y una puerta de entrada común | Hay que operarlo, mantener plugins y tener gente dedicada |
| Módulos o plantillas con CDK o Terraform | La infraestructura se repite y se quiere versionarla y revisarla como código | Los módulos evolucionan y los servicios existentes quedan atrás si no hay plan de migración |
| Scripts o CLI propios | Pocos equipos y un dolor puntual y bien acotado | Rápido de empezar, pero se vuelve difícil de mantener si crece sin dueño |
Empezaría por lo más chico que resuelva el dolor actual (módulos y un CLI fino) y sumaría un portal solo cuando el catálogo y la cantidad de equipos lo justifiquen. Comprar o adoptar algo existente ahorra construir, pero no ahorra operarlo.
Quién es dueño de qué
La plataforma no reemplaza a infraestructura. El equipo de plataforma es dueño de las plantillas, los pipelines y los guardrails, y cada equipo es dueño de sus servicios y de lo que corre adentro.
Esa frontera tiene que ser visible. Con documentación central, quien necesita saber qué hace un servicio o quién lo mantiene la mira ahí y no pregunta en un chat.
Cómo se revisan los cambios entre pares
Una plantilla es código que se replica, así que un error en ella se multiplica. Los cambios en plantillas y guardrails se tratan como cambios de producto: pull request, al menos una revisión del equipo de plataforma y otra de alguien que use la plantilla, que detecta lo que el autor no ve.
Cada cambio debería decir qué se rompe para los servicios existentes y cómo se migran. Ahí suelen fallar estos diseños: las plantillas evolucionan y los servicios ya creados quedan atrás.
Cuándo no armaría una plataforma
Con un equipo chico y uno o dos servicios, probablemente cueste más de lo que ahorra. Tampoco si el dolor real es otro, como un proceso de aprobación lento o requisitos poco claros, que una plataforma no arregla. Se justifica cuando la variación entre cómo hace cada uno las cosas ya cuesta de verdad.
Cuánto cuesta mantenerla
Es la parte que más se subestima. Una plataforma es un producto, con usuarios que se quejan y con deuda propia. Alguien tiene que mantener las herramientas, las plantillas y las guías, y una guía desactualizada es peor que ninguna. Sin personas con tiempo asignado para eso, no la empezaría.
Cómo medir si funciona
Como línea de base usaría las métricas DORA, en particular el lead time de los cambios (de commit a producción) y el change failure rate (qué proporción de despliegues causa una falla). Se miden antes de empezar y se comparan contra uno mismo, sin fijar un objetivo inventado.
Sumaría señales propias de la plataforma: cuánto tarda alguien nuevo en desplegar su primer cambio, qué proporción de servicios nuevos sale de la plantilla, cuántas excepciones se piden y por qué, y qué preguntas se repiten en soporte.
También vale preguntarle a los devs qué es lo que menos quieren tener que recordar. Esa lista suele orientar mejor que cualquier métrica.
Para empezar
Elegiría el trabajo repetido que más duele, lo convertiría en un único comando con una guía corta, dejaría los controles en el pipeline desde el primer día y documentaría la salida de emergencia antes de anunciar nada.